Dívida técnica tem juros: o que isso significa na prática
Dívida técnica não é sinônimo de código ruim. Entenda a origem do termo, por que nem toda dívida é um erro, e como a IA mudou o cálculo de quando pagá-la.

Você, seja desenvolvedor ou não, provavelmente já ouviu o termo “dívida técnica” em algum momento. É uma expressão bastante difundida na área de engenharia de software, usada em retrospectiva, em reunião de planejamento, até mesmo na hora do cafézinho. O problema é que, de tanto ser repetida, a expressão foi se esvaziando e, hoje, na maioria das vezes, “dívida técnica” virou só um jeito educado de dizer “código ruim”.
Não era essa a ideia original.
De forma simples, dívida técnica é o custo em tempo, esforço, ou confusão que alguém vai pagar depois por causa de uma decisão tomada durante o desenvolvimento de um software. Pode ser uma decisão consciente, pensada pra ganhar velocidade agora, ou pode ser uma decisão que parecia certa na hora e só depois se mostrou limitada. Nos dois casos, o software continua funcionando, só que carregando um compromisso que, mais cedo ou mais tarde, alguém vai precisar resolver.
O termo nasceu de uma metáfora de Ward Cunningham, um desenvolvedor bastante reconhecido na área, entre outras coisas, também criador do primeiro wiki da história. Em 1992, na conferência OOPSLA (sigla para Object-Oriented Programming, Systems, Languages, and Applications, um dos principais eventos de programação orientada a objetos da época), Cunningham escreveu um relatório curto sobre o WyCash, um sistema de gestão de portfólio financeiro que ele estava construindo na época. Foi nesse relatório que surgiu, pela primeira vez, a frase que décadas depois se tornaria um dos termos mais repetidos (e mais mal-entendidos) da área:
“Shipping first time code is like going into debt.”
Em tradução livre: lançar a primeira versão de um código é como contrair uma dívida.
Até aqui, parece simples: fazer rápido agora custa caro depois. Mas vale olhar o resto do que Cunningham escreveu naquele relatório, porque é ali que a metáfora faz mais sentido. Pra ele, contrair um pouco de dívida acelera o desenvolvimento — desde que ela seja paga em dia, através de reescrita. E cada minuto gasto mantendo código que não está exatamente certo conta como juros dessa dívida.
Ou seja: a dívida não nasce de escrever código ruim de propósito pra ganhar tempo. Ela nasce de lançar uma primeira versão baseada no entendimento que você tem do problema naquele momento (entendimento que é, por definição, incompleto) e de ir revisando essa versão conforme você aprende mais sobre o domínio. Michael Feathers resumiu essa leitura original de Cunningham numa frase que vale mais do que parece à primeira vista:
“Technical Debt was the accumulated distance between your understanding of the domain and the understanding that the system reflects.”
A distância acumulada entre o que você entende do domínio hoje e o que o sistema reflete. Essa distância é inevitável. Ninguém entende o problema por completo antes de começar a construir a solução, e quanto mais você constrói, mais aprende sobre o que deveria ter construído diferente. A dívida nasce exatamente desse gap, e nasce mesmo quando tudo foi feito com cuidado.
Nem toda dívida é um erro
Se a dívida é inevitável, a pergunta útil não é “existe dívida?”. Quase sempre existe. A pergunta que vale a pena fazer é outra: essa dívida foi contraída com critério, ou por desleixo?
Steve McConnell, em 2007, foi um dos primeiros a tentar separar os dois casos. Pra ele, existe a dívida intencional — uma decisão consciente de otimizar o presente em detrimento do futuro — e a dívida não intencional, que é resultado de trabalho malfeito, muitas vezes nem percebido enquanto acontece. E ele não trata as duas como a mesma coisa: em seu whitepaper sobre o tema, argumenta que parte da dívida técnica serve a propósitos reais de negócio, enquanto outra parte é simplesmente contraproducente, sem nenhum ganho real por trás.
Martin Fowler, outro programador renomado, autor de Refatoração, pegou essa divisão de McConnell e expandiu num quadrante que cruza dois eixos ao mesmo tempo: a dívida foi contraída de forma deliberada ou inadvertida, e foi prudente ou imprudente.
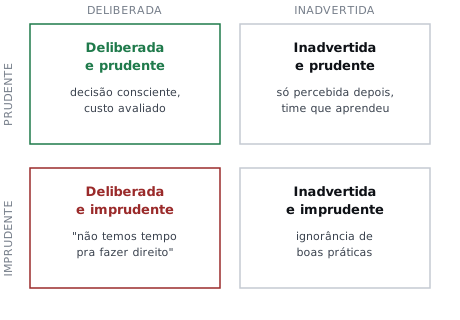
São quatro combinações possíveis:
- Deliberada e prudente: a decisão de contrair a dívida foi consciente, e o custo de pagá-la depois foi pesado contra o ganho de agir agora.
- Deliberada e imprudente: “não temos tempo pra fazer direito” — sabia que era o jeito errado, fez assim mesmo.
- Inadvertida e prudente: só se percebe depois, num time que aprendeu algo novo sobre o problema pelo caminho — é o preço natural de ficar melhor.
- Inadvertida e imprudente: dívida contraída por pura ignorância de boas práticas, sem nem perceber que estava se endividando.
A primeira célula costuma ser a mais mal compreendida das quatro, justamente porque ela não se parece com erro nenhum. Dívida deliberada e prudente não é falha de engenharia, e sim decisão de engenharia, com a mesma lógica de qualquer trade-off que envolve dinheiro: pesar o custo de agora contra o custo de depois, e escolher de olhos abertos, sabendo exatamente o que está sendo adiado e por quê. Ou um trade-off de tecnologia: manter um monólito no começo de um produto novo, mesmo sabendo que microsserviços facilitariam escalar depois, porque dividir cedo demais, antes de entender onde ficam os limites reais do domínio, traz uma complexidade que o time ainda não precisa pagar. O próprio Fowler defende essa escolha como ponto de partida razoável pra boa parte dos projetos, não como atalho irresponsável.
A parte que não se vê
Joel Spolsky, criador do Trello, muito antes de “dívida técnica” virar jargão comum, comparou software a um iceberg: a parte visível acima da água — a interface, a funcionalidade que o usuário final enxerga — é pequena perto do que sustenta ela por baixo. A metáfora foi adotada depois por outras pessoas especificamente pra falar de dívida técnica: o que está acima da linha d’água é o que foi entregue; o que está submerso é tudo que não se vê de fora: acoplamento, documentação que não existe, teste que falta, decisão que foi adiada e nunca mais revisitada.
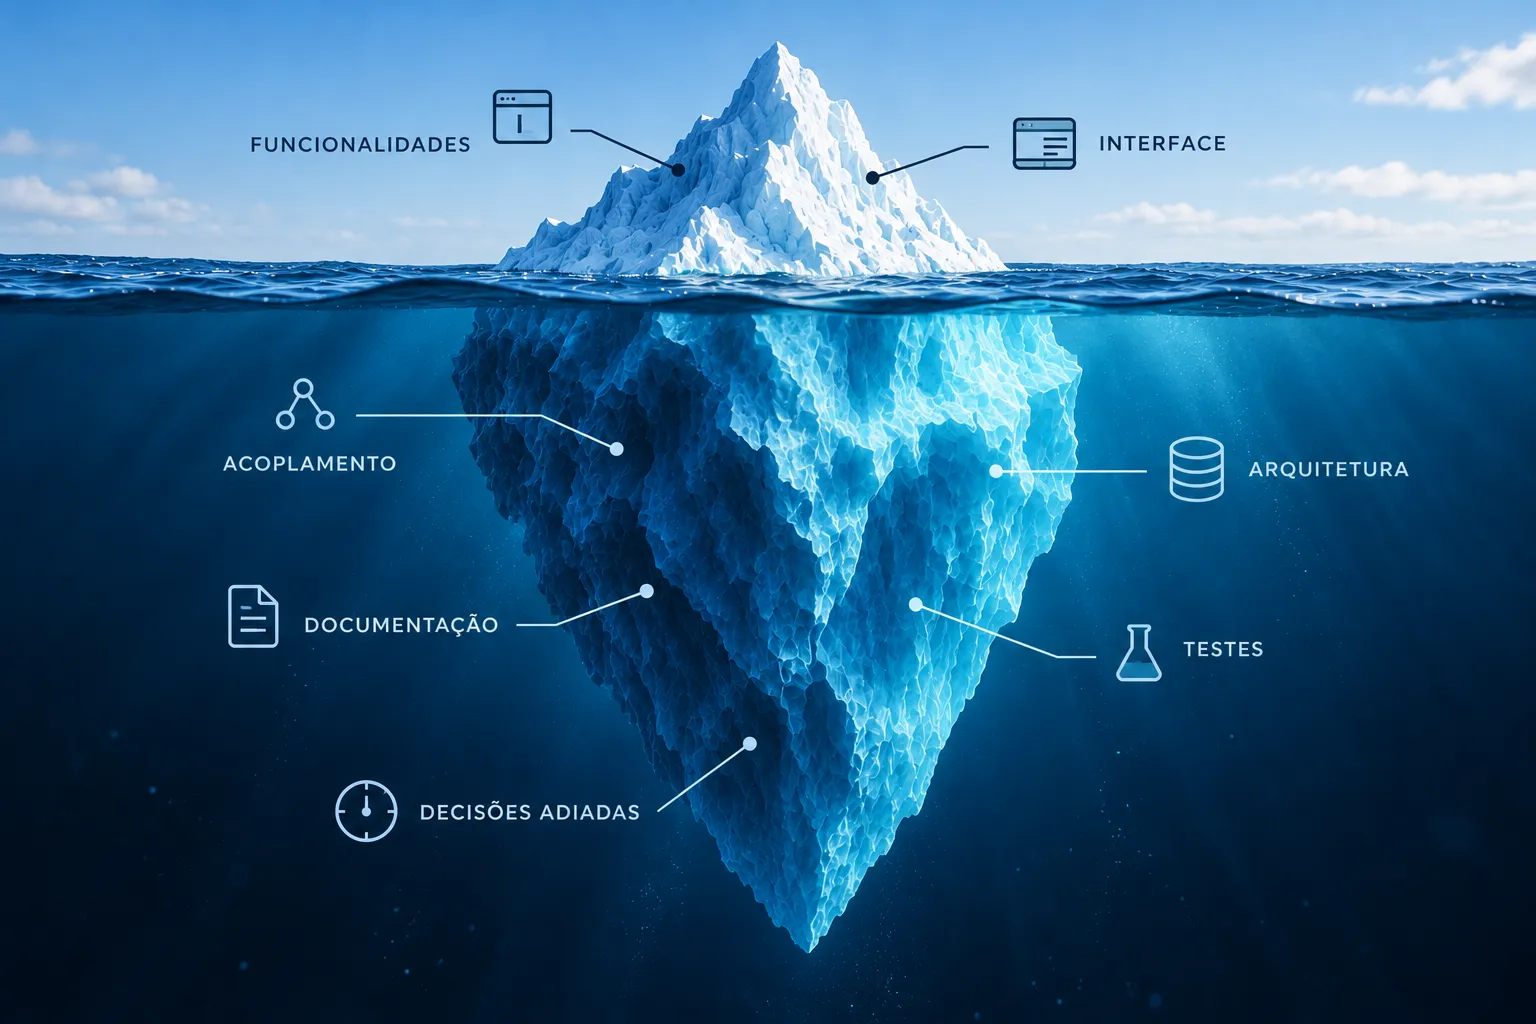
Quem está de fora só vê a ponta, e julga o software inteiro por ela.
Não é um modelo muito preciso, nem precisa ser. Serve só pra lembrar de uma coisa simples: a dívida raramente aparece na superfície. Ela se acumula onde ninguém está olhando, até o dia em que alguém precisa mexer justamente naquele ponto, e aí descobre o tamanho real do que estava escondido.
Um caso real: de desafios de tênis a gestão de escola
Tempos atrás, estava eu desenvolvendo um projeto que começou por meio de um curso sobre microsserviços, e depois, por decisão pessoal minha, decidi continuar o projeto e ampliei seu escopo e fiz algumas mudanças, fiz um pivot. O projeto se tratava de um sistema de challenges para jogadores de tênis, onde um jogador poderia desafiar outro, e o jogador desafiado poderia aceitar, recusar, e depois, caso tivesse aceito o desafio, cancelá-lo. Então achei uma boa ideia ampliar o projeto para um sistema de gerenciamento de escolas de tênis, onde esse recurso de challenges entre jogadores (aí passaria para jogadores da própria escola) seria apenas um plus dentro de um ecossistema maior. A aplicação ganhou um sistema de ranqueamento entre os jogadores, onde os jogadores de cada escola (sistema multi-tenancy, cada escola tinha seus jogadores e professores) poderiam desafiar uns aos outros (também foi ampliado o status de respostas para cada desafio, como propor uma nova data para o desafio), e assim, conforme os resultados das partidas, e também desempenho na escola, no geral, eles aumentariam ou diminuiriam as suas pontuações. E cada jogador começava com uma pontuação default, na categoria E com 200 pontos, podendo chegar até a categoria GOLD (acima da A). Esse sistema de ranqueamento e pontuação era uma forma de manter os alunos motivados e incentivar uma competição saudável entre eles.
Abaixo estão algumas amostras do código que ajudam a entender o sistema como um todo.
// apps/api/src/modules/students/entities/category-info.enum.ts
export enum CategoryInfo {
    CATEGORY_GOLD = 'Category Gold - The students with more than 12,000 points but not more than 30,000 points',
    CATEGORY_A = 'Category A (World Elite) → 8,001 - 12,000 points',
    CATEGORY_B = 'Category B (High-Level Professionals) → 4,001 - 8,000 points',
    CATEGORY_C = 'Category C (Advanced Competitors) → 1,001 - 4,000 points',
    CATEGORY_D = 'Category D (Growing Intermediate Students) → 501 - 1,000 points',
    CATEGORY_E = 'Category E (Beginners and New Students) → 200 - 500 points'
}
// apps/api/src/modules/challenges/entities/challenge-status.enum.ts
export enum ChallengeStatus {
FINISHED = 'FINISHED',
PENDING = 'PENDING',
ACCEPTED = 'ACCEPTED',
DECLINED = 'DECLINED',
CANCELED = 'CANCELED'
}// apps/api/src/modules/schools/domain/entities/school-status.enum.ts
export enum SchoolStatus {
ACTIVE = 'active',
INACTIVE = 'inactive',
TRIAL = 'trial',
SUSPENDED = 'suspended',
CANCELED = 'canceled',
PENDING_APPROVAL = 'pending_approval',
DELETED = 'deleted'
}
/**
* active -> school account is fully active and operational
* inactive -> created but not yet activated (e.g. email not verified or setup incomplete)
* trial -> in trial period, with temporary access and feature limitations
* suspended -> access temporarily blocked (e.g. billing issues or policy violation)
* cancelled -> account closed by the school or system administrator
* pending_approval -> awaiting internal review or approval before activation
* deleted -> soft-deleted tenant, data retained for audit or recovery
*/Mas onde eu quero chegar com tudo isso? Bom… Um ponto importante a dizer é que o projeto do curso foi iniciado com o banco de dados MongoDB, um banco não-relacional. Até aí tudo bem, pois estava aprendendo sobre microsserviços na época e qualquer coisa relacionada a dívida técnica estava longe do meu foco. O problema foi que, mesmo após mudar o rumo do projeto e perceber que o projeto exigiria um banco relacional, decidi continuar com o banco utilizado desde o início do curso. Afinal, o projeto feito no curso não tinha testes, não utilizava o padrão de design Repository, e nessa época também o desenvolvimento agêntico não estava tão forte como hoje. Enfim… conforme o projeto avançava isso ficava cada vez mais claro: é necessário um banco relacional.
Hoje, com mais clareza técnica, consigo listar exatamente o que tornava o Mongo inadequado pra esse domínio específico. O sistema é multi-tenant, ou seja, cada escola tem seus próprios alunos, professores e desafios, e esse isolamento por tenant é natural num banco relacional, onde uma simples foreign key já garante que um aluno nunca apareça vinculado à escola errada. Além disso, o domínio é denso em relacionamentos: aluno se liga a escola, a professor, a categoria de ranking, a desafios, e cada desafio, por sua vez, se liga a dois jogadores ao mesmo tempo. O ChallengeStatus que aparece acima não é só uma lista de estados soltos: cada transição, como de PENDING pra ACCEPTED até a resolução do desafio, precisa atualizar a pontuação dos dois jogadores envolvidos numa única operação atômica. Cheguei até a implementar isso usando transações ACID multi-documento do MongoDB, recurso que o banco só passou a suportar a partir da versão 4.0, mas mesmo com a atomicidade resolvida, o esforço de modelar os relacionamentos continuava alto: cada consulta que cruzava aluno, escola e desafio exigia referência manual entre documentos, sem garantia de integridade referencial nativa, e a lógica de validar essas referências ficava espalhada pela aplicação em vez de garantida pelo próprio banco. Resolver a atomicidade não resolvia o problema de fundo, que era modelar um domínio fortemente relacional num banco que não foi pensado pra isso. Se uma das duas atualizações de pontuação fosse aplicada e a outra falhasse, o ranking ficaria inconsistente, como um jogador ganhando pontos sem o outro perder. Isso é exatamente o tipo de garantia que uma transação de banco relacional resolve de forma nativa, e que um banco de documentos como o Mongo exige simular com bem mais esforço e bem menos segurança.
Mas resumindo o final da história… decidi finalmente fazer a migração para um banco relacional, o PostgreSQL. A migração deu um pouco de trabalho pois muita coisa já tinha sido feita, mas com a assistência de um agente de IA, ela foi feita com segurança, seguindo passos lógicos, medíveis e testáveis (criei um “epic” no GitHub Projects com as issues necessárias). E sobre o status do projeto atualmente, bom ele foi descontinuado, mas talvez retorne com ele no futuro, se eu achar viável.
O que a IA mudou — não o julgamento, o custo
Vale separar duas coisas que costumam ficar misturadas quando esse caso é contado. Uma é se a decisão de adiar a migração continuava fazendo sentido com o passar do tempo (e continuava, pelos mesmos motivos de antes). A outra é quanto custava, na prática, finalmente executar essa migração, e isso, sim, mudou.
Essa separação importa porque isola exatamente o que a IA muda: não se uma decisão foi certa ou errada no momento em que foi tomada, mas quanto custa agir a partir dela hoje. Uma migração que antes exigia reescrever manualmente cada ponto de acesso a dados, sem rede de segurança e sem padrão de repositório pra isolar a mudança, hoje pode ser conduzida por um agente capaz de entender o código existente, propor a alteração, e ainda implementar o que faltava como o repository pattern e, no final, verificar o resultado numa fração do tempo que levaria antes.
Isso torna todo o processo de avaliação de dívidas muito mais fácil, tornando o pagamento delas barato e rápido.
Quando a dívida foge do controle
Nem toda dívida adiada continua sendo prudente pra sempre, e vale marcar essa diferença antes de fechar o texto. Marco Tulio Valente, em Manutenção de Software, lista o aumento do tempo de onboarding de novos desenvolvedores como um dos sintomas mais comuns de dívida técnica que deixou de ser administrada. Quanto mais dívida acumulada sem reavaliação, mais tempo alguém novo leva pra entender o sistema antes de conseguir contribuir com segurança.
Isso não é um problema hipotético, nem exclusivo de empresa pequena. O próprio Google, segundo o livro, aplica uma pesquisa trimestral com seus times de desenvolvimento perguntando diretamente: “sua equipe incorreu deliberadamente em dívida técnica nos últimos três meses?”, ou seja, trata dívida técnica como algo que precisa ser medido e acompanhado continuamente, não resolvido uma vez e esquecido.
Refletindo sobre tudo isso, é pouco provável que alguém, em algum projeto que chegue nesse ponto de ter um problema real, tenha decidido de forma deliberada e prudente deixar a dívida se acumular até ali. O que geralmente acontece é uma sequência inteira de decisões razoáveis, cada uma fazendo sentido no momento em que foi tomada, sem que ninguém pare periodicamente pra reavaliar se elas continuam fazendo sentido juntas. Com o tempo, a dívida acumulada deixa de ser um detalhe gerenciável e passa a definir, na prática, o que a equipe consegue ou não fazer.
O ponto importante aqui é a necessidade de sempre fazer o questionamento ao longo do tempo: essa decisão ainda faz sentido?
Na prática, isso costuma significar três mecanismos simples, não ferramentas sofisticadas. O primeiro é repetir a pergunta do Google: perguntar ao time, em intervalo fixo, se alguma dívida foi contraída deliberadamente recentemente; não espera o problema aparecer sozinho, cria espaço pra ele ser nomeado. O segundo é manter a dívida conhecida registrada em algum lugar visível pro time inteiro, do mesmo jeito que se trata um bug: uma dívida que só existe na cabeça de quem a contraiu desaparece junto com essa pessoa, seja por esquecimento, seja por ela sair do time. O terceiro é documentar o porquê de uma decisão no momento em que ela é tomada, por exemplo, com um ADR (Architecture Decision Record) curto, registrando o contexto e o trade-off. Isso é o que permite reavaliar a decisão meses depois com a mesma informação que existia na hora, em vez de reconstruir a lógica de memória ou, pior, concluir que ela nunca teve lógica nenhuma.
Fechamento
Kruchten, Nord e Ozkaya, no livro Managing Technical Debt, defendem tratar a dívida técnica como mais um insumo de decisão dentro do desenvolvimento de software, algo que entra na mesma mesa de prioridades que qualquer outra escolha de arquitetura, em vez de um pecado a ser confessado depois que alguém finalmente percebe.
A pergunta que fica, então, não é “este projeto tem dívida técnica?”. Quase todo projeto tem, em algum grau. A pergunta que realmente importa não é apenas em qual célula do quadrante cada dívida está, mas se essa classificação ainda vale hoje.